IA aplicada · Ferramenta de pesquisa
Pensieve
Um acervo de pesquisa que compara geração aumentada por recuperação de informações com prompts de contexto completo, sempre conectando as respostas às suas fontes.
- Atuação
- Engenharia full stack e interação
- Tecnologias
- Next.js, FastAPI, pgvector, Gemini
O problema
Uma resposta gerada por IA só é útil se puder ser conferida. O Pensieve apresenta duas formas de consultar um corpus literário: recuperar os trechos relevantes ou enviar um contexto maior diretamente ao modelo.
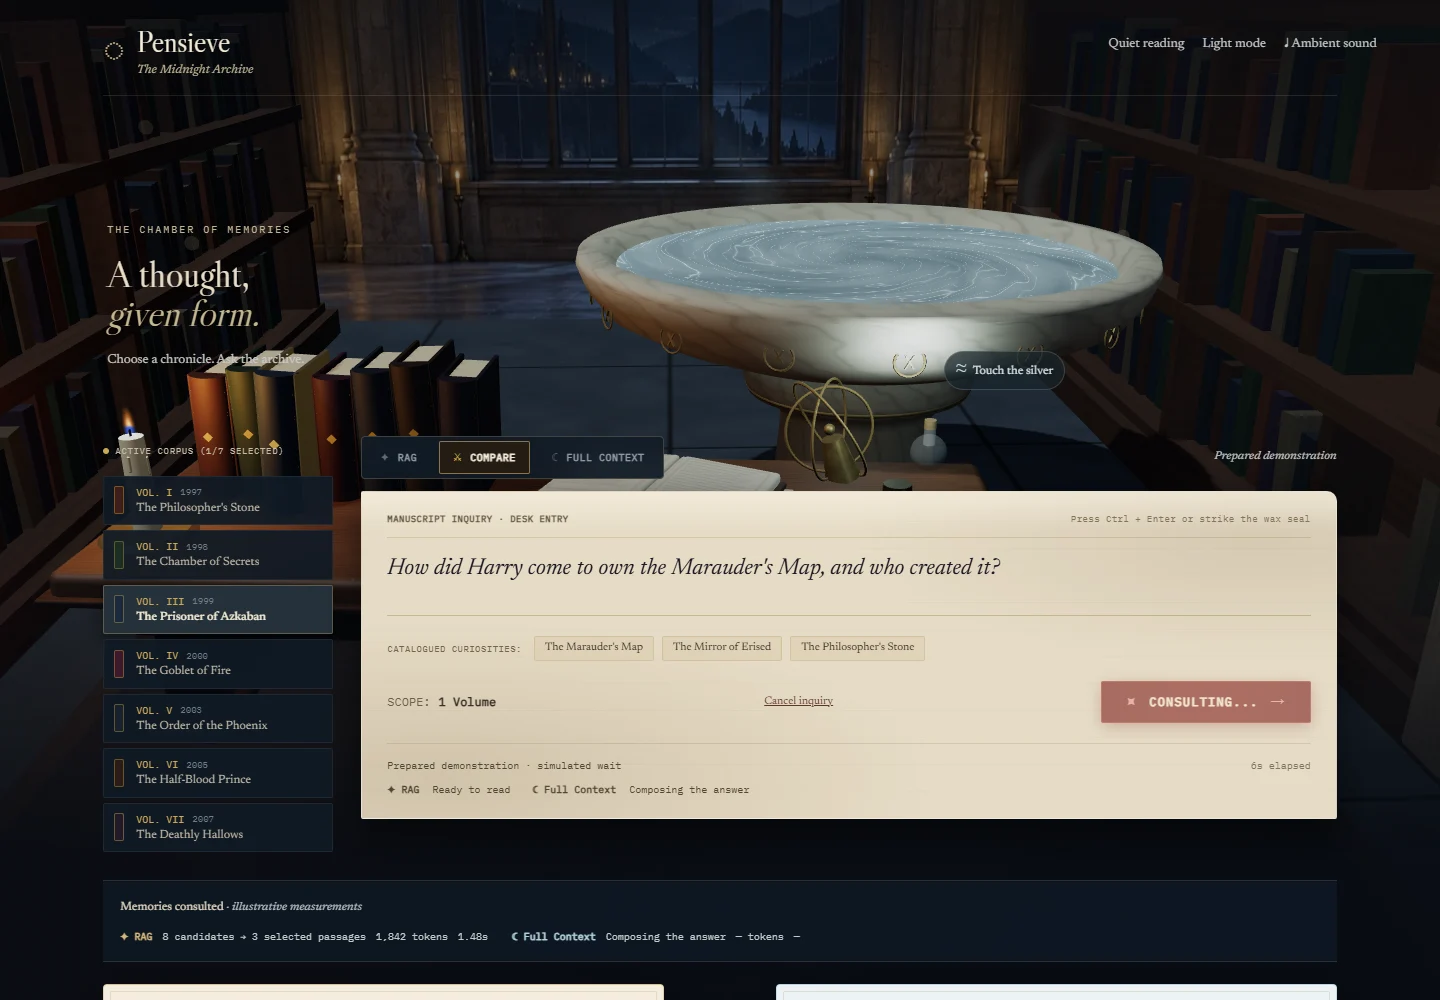
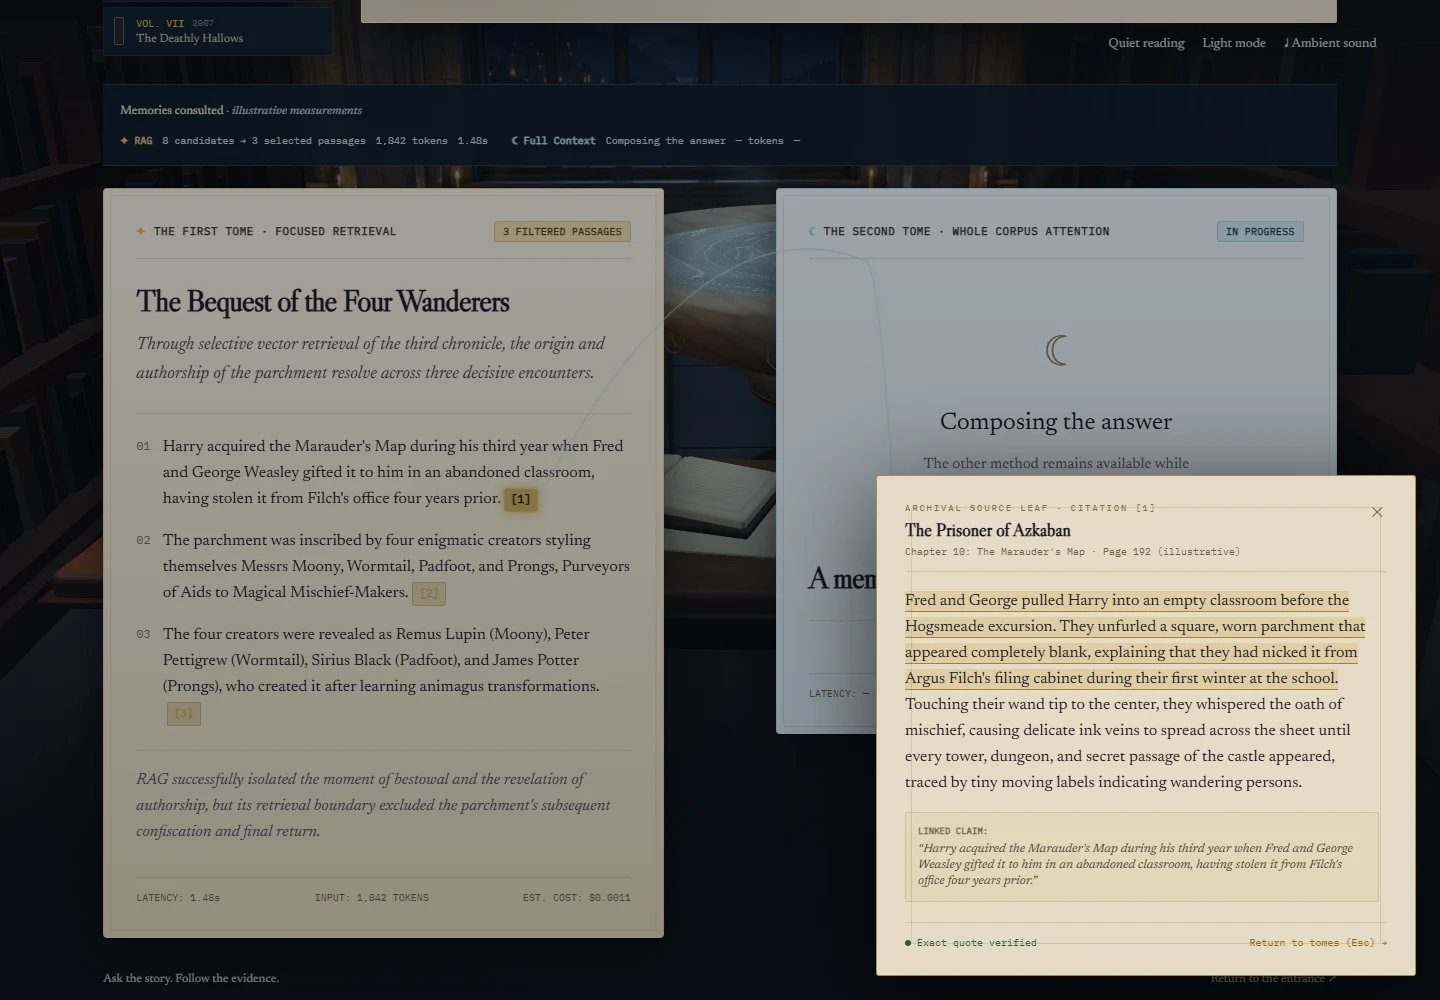
A interface é um acervo. Cada pergunta abre dois livros, um para cada método. As citações levam ao trecho exato do texto fornecido, enquanto um modo de leitura mais discreto mantém o foco nas evidências.
Decisões de engenharia
Manter a fonte junto da resposta
PostgreSQL e pgvector conectam os trechos indexados às execuções persistidas. Os intervalos das citações são conferidos no texto fornecido e passam por uma segunda revisão semântica.
Permitir uma comparação verificável
RAG e contexto completo têm resultados, latência, uso de tokens e estimativas de custo separados. Estimativas contábeis ficam distintas de qualquer comprovação de cobrança real.
Deixar a ambientação como opção
Um acervo em WebGL apresenta o projeto. A mesa de pesquisa permanece no DOM, com acesso por teclado, movimento reduzido e uma opção para pular a animação.
O que foi desenvolvido
Uma aplicação funcional com Next.js, FastAPI, pgvector e integração ao Gemini, além de um modo de demonstração identificado separadamente. O acesso ao corpus e as cotas do provedor limitam os experimentos ao vivo; esses limites estão documentados no repositório.
Ver código-fonteEvidências de uma execução real
O que o experimento mostrou.
Uma rodada real com o Gemini revelou falhas nas citações e limites do provedor. Esses achados mudaram a recuperação de evidências, a revisão das respostas e o tratamento de solicitações grandes.
- capítulos no corpus
- 57
- páginas de texto-fonte
- 914
- trechos indexados
- 738
Citações exatas exigem mais que um prompt
O modelo alterava ou combinava citações livres. Agora seleciona IDs de trechos, e o backend resolve o texto e a posição na fonte original. Uma segunda revisão semântica confere cada afirmação factual contra os trechos citados.
O contexto completo encontrou um limite real
As seis tentativas com escopos de um, dois e três livros falharam com HTTP 503 ou 429. A interface atual conta os tokens antes da geração e recusa solicitações de contexto completo acima de 30.000 tokens, sem cortar a fonte silenciosamente.
A busca RAG precisava equilibrar os livros
As primeiras sínteses concentravam evidências em alguns livros. A busca passou a combinar candidatos por livro e ampliar trechos vizinhos. O relatório registra as falhas e as correções decorrentes delas.
Esta rodada não demonstra que RAG é melhor que contexto completo: as seis tentativas grandes de contexto completo falharam antes de produzir uma resposta. A revisão por modelo é uma verificação, não uma garantia de correção. Textos privados e registros de sessão não são publicados.